5.4.1 Faktorvariabler og interaksjonsledd
Faktorvariabler kan brukes til å automatisere omkoding av flerkategorivariabler slik at de kan brukes i et regresjonsuttrykk. I praksis vil hver kategori minus referansekategorien representeres ved separate dummyvariabler, der en tolkningsmessig måler effekten av de enkelte kategorier sammenliknet med referansekategorien. Man bruker da prefikset i. foran variabelnavnet i det aktuelle regresjonsuttrykket. Den laveste verdien vil som standard benyttes som referanseverdi. Dersom en kategorisk variabel har 8 kategorier med kodeverdiene 1-8, så velges altså kategorien 1 som referansegruppe, og man får estimert 7 koeffisienter knyttet til de øvrige kategoriene.
Faktorvariabler kan også brukes til å estimere effekten av kombinasjoner av verdier for to utvalgte kategoriske variabler. Til dette brukes operatoren # eller ## til å lage interaksjonsledd. Rasjonalet bak er at enkelte egenskaper har ulik effekt på den avhengige variabelen når en ser på ulike grupper. F.eks. kan effekten av utdanning på fremtidig inntekt være systematisk forskjellig for menn versus kvinner. Om en har slike antakelser, kan faktorvariabler komme til nytte.
Symbolet # brukes til å angi at kategoriene til to variabler skal kombineres og estimeres. Den ene variabelen får sin egen blokk med estimater, mens den andre bare opptrer i kombinasjon med den første.
Ved bruk av ## settes interaksjonene opp på en alternativ måte, der begge variablene får sin egen blokk med estimater før kombinasjonene vises.
Når man benytter # eller ##, kan man fritt velge om man vil benytte prefikset i. foran variablene som skal inngå i et interaksjonsledd. Analysesystemet forstår automatisk at dette er kategoriske variabler siden de inngår i et interaksjonsledd, så det er i de fleste tilfeller ikke nødvendig å legge til i. som prefiks. Men prefikset er essensielt om man vil opprette faktorledd.
For å få interaksjonsestimater som kan tolkes på samme måte som i andre analyseverktøy, anbefales det å benytte operatoren ##. Brukes derimot #, må estimatene tolkes på en litt annen måte.
Prefikset c. kan benyttes til å signalisere at en variabel skal regnes som en kontinuerlig variabel (ikke-kategorisk). Dette kan være aktuelt å bruke i de tilfeller hvor en variabel både kan tolkes som kategorisk og kontinuerlig, f.eks. utdanningsnivå eller alder.
Enkel interaksjonsoperator (#)
Dersom man bruker operatoren # i en regresjonskommando, vises to blokker med estimater. Først en blokk for den sist nevnte variabelen, målt innenfor referansegruppen til den først nevnte. Deretter en blokk der den først nevnte variabelen er brutt ned på hvert nivå av den sist nevnte.
Kompakt skrevet:
a#b gir b* + a*:b
(Tegnet * betyr at referansekategorien ikke estimeres)
Merk at rekkefølgen til variablene a og b ikke er likegyldig, dvs. at a#b returnerer andre estimater enn b#a.
Tolkning av estimatene
Tolkning av estimatene som returneres ved bruk av # er litt annerledes enn for vanlige koeffisientestimater:
-
Det som ser ut som rene effektestimater for variabel b (leddet b*) er egentlig effekter av b for referansegruppen til a. Referansekategorien er kombinasjonen av laveste verdi for a og b.
-
Estimatene for kombinasjonene av a og b (leddet a*:b) viser egentlig effekten av a rapportert separat innenfor hvert nivå av b. Referansekategorien er referansegruppen til a for hvert nivå av b.
Eksempel 1:
Man benytter et interaksjonsledd for kombinasjoner av variablene kjønn og kohort_alder:
kjønn#kohort_alder
Kjønn har to kategorier (1 – Mann, 2-Kvinne), mens kohort_alder har fem alderskohorter. Til sammen gir dette 10 kombinasjoner minus referansegruppen, altså er det 9 effekter som skal estimeres.
Følgende regress-kommando kjøres:

Dette returnerer følgende interaksjonsestimater (viser bare estimater for koeffisientverdi, standardfeil, t-verdi og p-verdi knyttet til interaksjonsleddet):
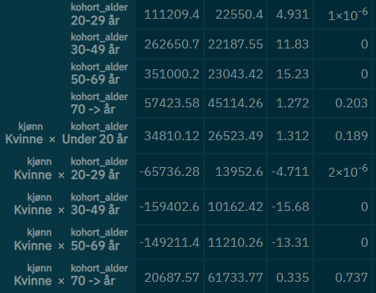
Merk at de fire øverste estimatene som tilsynelatende viser rene alderseffekter i forhold til referansekategorien (under 20 år), egentlig viser effekten av alder for referansegruppen til kjønn (=menn). Altså tilsvarer disse linjene følgende estimater med referansekategori = «Mann x Under 20 år»:
- 20-29 år → Mann x 20-29 år
- 30-49 år → Mann x 30-49 år
- 50-69 år → Mann x 50-69 år
- 70 -> år → Mann x 70 -> år
Estimatet for gruppen 30-49 år er altså differansen i lønn mellom menn i denne aldersgruppen sammenliknet med menn i referansealdersgruppen (Under 20 år).
De siste fem linjene skal tolkes som kjønnsforskjeller innen hver aldersgruppe:
- Kvinne x Under 20 år
- Kvinne x 20-29 år
- Kvinne x 30-49 år
- Kvinne x 50-69 år
- Kvinne x 70 -> år
Estimatet for gruppen «Kvinne x 30-49 år» er altså differansen i lønn mellom kvinner og menn i denne aldersgruppen.
Eksempel 2:
Man benytter et interaksjonsledd for kombinasjoner av variablene kohort_alder og kjønn (altså de samme variablene i motsatt rekkefølge):
kohort_alder#kjønn
Det blir fortsatt 10 kombinasjoner av kategorier som skal estimeres minus referansekategori, i alt 9 estimater. Modellen som kjøres ser da slik ut:

Merk at estimatene knyttet til interaksjonsleddet nå blir annerledes enn eksempel 1:
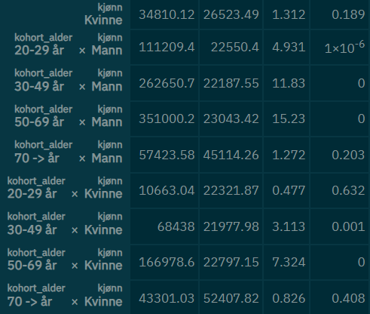
Her ser det ut som at første linje viser den rene kjønnseffekten (Kvinne vs. referansekategori= mann). Men det som vises er egentlig effekten av «Kvinne» i referansealdersgruppen («Under 20 år»):
- Kvinne → «Kvinne x Under 20 år»
Referansekategori for den første linjen er menn under 20 år (kategorien med de laveste verdikombinasjonene for de to variablene, slik som i eksempel 1).
De neste 8 estimatene viser egentlig aldersforskjeller for hvert kjønn:
- Mann x 20-29 år
- Mann x 30-49 år
- Mann x 50-69 år
- Mann x 70 -> år
- Kvinne x 20-29 år
- Kvinne x 30-49 år
- Kvinne x 50-69 år
- Kvinne x 70 -> år
Estimatet for gruppen «Kvinne x 30-49 år» skal nå tolkes som differansen i lønn for kvinner i denne aldersgruppen sammenliknet med kvinner i referansealdersgruppen (Under 20 år). Og estimatet for «Mann x 30-49 år» skal tolkes som differansen i lønn for menn i denne aldersgruppen sammenliknet med menn i referansealdersgruppen (Under 20 år).
Når man sammenligner estimatene fra bruk av kjønn#kohort_alder med kohort_alder#kjønn (motsatt rekkefølge), er fem av de ni estimatene identiske. Dette er tallene som viser kjønnsgapet blant de yngste og de fire alderseffektene blant menn.
De fire øvrige estimatene er ulike, fordi de svarer på ulike spørsmål: Kjønnsgapet i hver aldersgruppe i det første tilfellet, alderseffektene blant kvinner i det andre. Begge oppsett beskriver de samme lønnsforskjellene, men leser dem fra hver sin kant.
Når bør man bruke a#b, og når bør man bruke b#a?
Gjennom å endre på rekkefølgen av variabel a og b i et interaksjonsledd der # benyttes, kan man styre hvilke effekter på den avhengige variabelen man vil undersøke:
-
Kjønn#Kohort_alder→ Hvordan er kjønnsprofilen i hver aldersgruppe? Referansekategori er det andre kjønnet i samme alderskohort. -
Kohort_alder#Kjønn→ Hvordan er alderprofilen innenfor hvert kjønn? Referansekategori er laveste alderskohort for det aktuelle kjønnet.
Dobbel interaksjonsoperator (##)
Dersom man bruker operatoren ## i en regresjonskommando, vises tre blokker med estimater. Først en blokk for hver av de to variablene hver målt innenfor referansegruppen til den andre. Deretter en blokk med kombinasjonene:
a##b gir a* + b* + a*:b*
(Tegnet * betyr at referansekategorien ikke estimeres.)
Til forskjell fra # er rekkefølgen likegyldig. Uttrykkene a##b og b##a gir de samme estimatene, bare at rekkefølgen i resultattabellen endres.
Antall estimater blir det samme som ved bruk av #. Med to kjønn og fem alderskohorter gir begge operatorene 9 estimater.
Tolkning av estimatene
Estimatene fra ## tolkes på den måten man er vant til fra andre analyseverktøy.
Leddet a* er effekten av a innenfor referansekategorien til b. Merk at dette ikke er en gjennomsnittlig effekt av a på tvers av alle kategorier av b, selv om estimatet står alene i tabellen.
Leddet b* er tilsvarende effekten av b innenfor referansekategorien til a.
Leddet a*:b* er ikke en effekt i seg selv, men en forskjell mellom effekter. Det viser hvor mye effekten av a i denne kategorien av b avviker fra effekten av a i referansekategorien til b.
Eksempel 3:
Dersom man velger å kjøre en tilsvarende regresjonsmodell som i eksemplene over, med interaksjonsledd for variablene kjønn og kohort_alder, men med bruk av operatoren ## i stedet, blir kommandouttrykket slik:

Estimatene knyttet til interaksjonsleddet kjønn##kohort_alder får et litt annet oppsett:
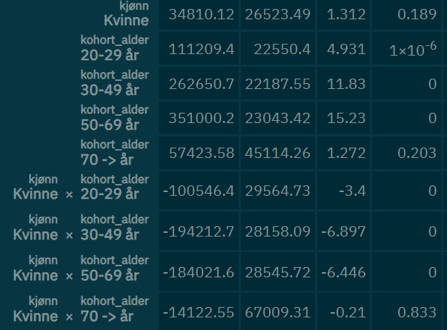
Også i dette tilfellet er referansekategorien «Mann x Under 20 år», i tillegg til at modellen gir 9 estimater fordelt på tre blokker:
-
Ett kjønnsestimat, «Kvinne». Dette er kjønnsgapet blant dem under 20 år, altså differansen i lønn mellom kvinner og menn i referansealdersgruppen.
-
Fire aldersestimater, fra «20-29 år» til «70 år og over». Disse er alderseffekter blant menn, altså differansen i lønn mellom menn i den aktuelle aldersgruppen og menn under 20 år.
-
Fire kombinasjonsestimater, fra «Kvinne x 20-29 år» til «Kvinne x 70 år og over». Disse viser hvor mye kjønnsgapet i den aktuelle aldersgruppen avviker fra kjønnsgapet blant dem under 20 år.
Estimatet for «Kvinne x 30-49 år» skal altså ikke leses som kjønnsgapet i aldersgruppen 30-49 år. Det er forskjellen mellom kjønnsgapet i denne aldersgruppen og kjønnsgapet i referansealdersgruppen. Er estimatet negativt, betyr det at kvinner kommer relativt dårligere ut i aldersgruppen 30-49 år enn de gjør blant de yngste.
Vil du finne selve kjønnsgapet i aldersgruppen 30-49 år, legger du sammen «Kvinne» og «Kvinne x 30-49 år».
Vil du finne den predikerte lønnen til kvinner i aldersgruppen 30-49 år, legger du sammen konstantleddet, «Kvinne», «30-49 år» og «Kvinne x 30-49 år».
Merk at estimatene for de fem første linjene blir identiske med eksempel 2 som bruker interaksjonen kohort_alder#kjønn. Det er ingen tilfeldighet ettersom begge viser kjønnsgapet blant de yngste og alderseffektene blant menn.
Også resten henger sammen. Kombinasjonssestimatene som returneres gjennom ## er differansen mellom de to siste blokkene fra #. Estimatet «Kvinne × 30-49 år» i ## er kjønnsgapet i denne aldersgruppen minus kjønnsgapet blant de yngste, og begge disse tallene finner du i #-tabellen.
Hele ##-tabellen kan altså regnes ut fra #-tabellen. De inneholder samme informasjon, bare bokført på hver sin måte.
Den beskrevne sammenhengen gjelder kohort_alder#kjønn mot kjønn##kohort_alder. Bruker man kjønn#kohort_alder i stedet, finnes de samme tallene, men de står ikke på samme linjer.
Hva kombinasjonsestimatene tester
Estimatene i det siste leddet tester om effekten av den ene variabelen varierer med den andre. Er ingen av dem signifikante, tyder det på at kjønnsgapet er omtrent like stort i alle aldersgrupper. Det betyr ikke at kjønnsgapet er null, bare at det ikke endrer seg systematisk med alder.
Dette er en annen test enn den man får med #, og det er den viktigste praktiske forskjellen mellom de to operatorene.
Forskjellen mellom # og ## i praksis
Uansett hvilken av de fire variantene man velger – kjønn#kohort_alder, kohort_alder#kjønn, kjønn##kohort_alder eller kohort_alder##kjønn - estimerer du samme modell. Antall estimater er det samme, referansekategorien er den samme, og de predikerte lønningene for hver gruppe blir identiske.
De fem første av de ni estimatene går dessuten igjen i alle fire oppsett: Kjønnsgapet blant de yngste og de fire alderseffektene blant menn. Det varierer hvor de står og hva de heter, men tallene er de samme.
De fire siste estimatene er det som skiller variantene. Her velger du hvilken sammenligning du vil lese direkte ut av tabellen, basert på interaksjonsvariant, mens de øvrige må regnes ut. Ingen av variantene gir mer informasjon enn de andre — de fremhever bare ulike deler av det samme bildet.
| Egenskap | Med # | Med ## |
|---|---|---|
| Antall estimater | Likt | Likt |
| Predikerte verdier og forklart varians | Identisk | Identisk |
| Betydning av rekkefølgen | Rekkefølgen endrer estimatene | Rekkefølgen er likegyldig |
| Kjønnsgapet i referansealderen | Ja, avhengig av rekkefølgen | Vises som eget estimat |
| Gruppeforskjeller kan leses direkte | Ja, avhengig av rekkefølgen | Nei, må summeres |
| Test av om kjønnsgapet varierer med alder | Nei | Ja |
| Sammenliknbart med andre verktøy | Nei | Ja |
Verken # eller ## gir rene hovedeffekter. Uansett hvilken du velger, er hvert estimat knyttet til en bestemt referansekategori for den andre variabelen: Estimatet «Kvinne» i eksemplene over er kjønnsgapet blant dem under 20 år, ikke kjønnsgapet generelt, og estimatet «30-49 år» er alderseffekten blant menn, ikke alderseffekten generelt.
Operatoren # gir deg ferdig utregnede forskjeller innenfor hvert nivå, mens ## gir deg et utgangspunkt pluss et mål på hvordan effekten endrer seg derfra.
Hvilken bør man velge?
Velg ## når du vil undersøke om effekten av en variabel avhenger av en annen, eller når resultatene skal sammenlignes med analyser gjort i andre verktøy.
Velg # når du først og fremst vil lese av gruppeforskjeller direkte, for eksempel kjønnsgapet i hver enkelt aldersgruppe, uten å måtte summere estimater.
Er du i tvil, bruk ##. Du kan alltid regne deg fram til tallene # ville gitt ved å summere, mens motsatt vei krever at du kjenner oppbygningen godt.
Det er også mulig å velge bort bruk av # evt. ##, og heller sette opp kombinasjoner av dummyer på en manuell måte. Da har man full kontroll på hvordan estimatene skal tolkes. Lager man f.eks. én dummy per kombinasjon av kategorier og utelater en av dem som referanse, blir hvert estimat differansen mellom den aktuelle gruppen og referansegruppen.
Sammenliknbarhet med andre analyseverktøy
Operatoren ## gir estimater som er direkte sammenlignbare med andre analyseverktøy. Bruk denne dersom resultatene skal sammenlignes med analyser gjort andre steder.
Operatoren # gir en annen oppdeling av de samme forskjellene. Modellen og de predikerte verdiene er identiske, men de enkelte estimatene kan ikke sammenlignes direkte med tall fra andre verktøy. Årsaken er at et interaksjonsledd uten hovedeffekter kan parametriseres på flere likeverdige måter, og at verktøyene velger ulikt. Microdata.no følger konvensjonen i formelbiblioteket formulaic.
Kilde
Formelen som genereres i Python gjennom bruk av operatorene # og ## er hhv. C(a):C(b) og C(a)*C(b). Begge håndteres av samme bibliotek, formulaic.
- Formulaic, hovedside: https://matthewwardrop.github.io/formulaic
- Formulaic, formelgrammatikk: https://matthewwardrop.github.io/formulaic/latest/guides/grammar/
- Patsy («How formulas work»): https://patsy.readthedocs.io/en/latest/formulas.html
- Wilkinson og Rogers (1973) er opphavet til formelnotasjonen som både R, patsy og formulaic bygger på.